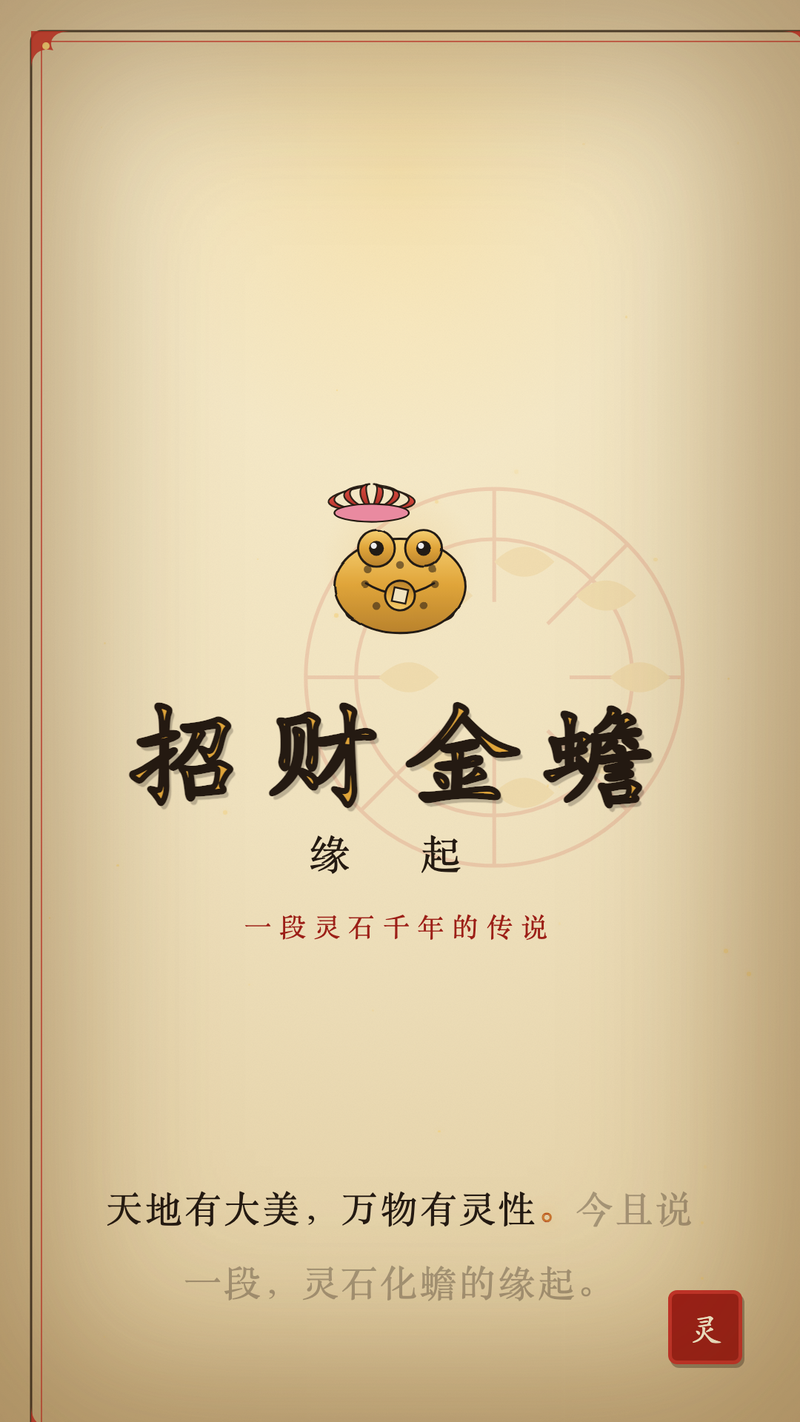
标题卡 · 招财金蟾
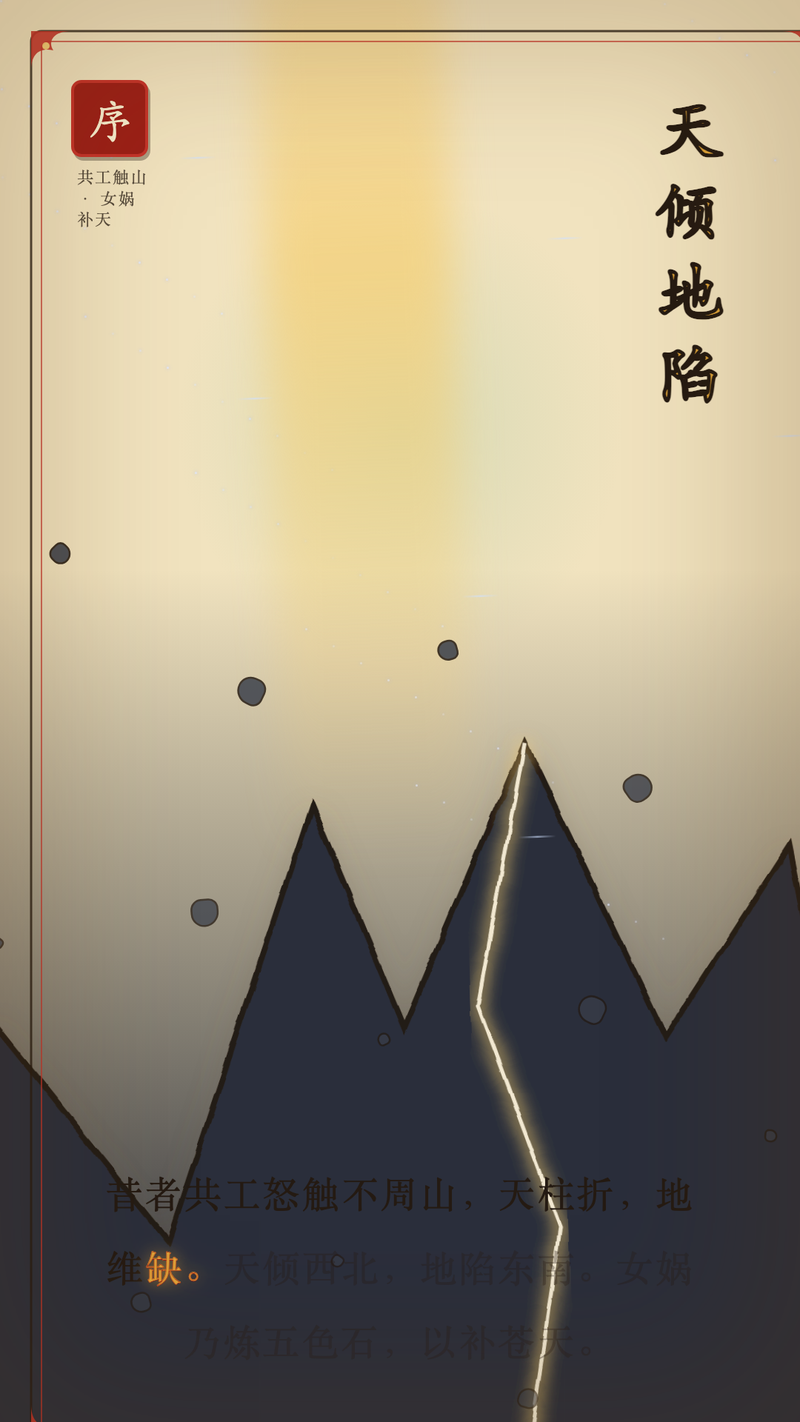
序 · 天倾地陷
招财金蟾 · 缘起 | 四次迭代,从机械朗读到九幕神话,最终 98 秒
摘要:本文记录了我使用 Remotion 程序化视频框架 + Edge TTS 神经网络语音,从零制作一支 98 秒中国神话动画短片的全过程。经历四次大版本迭代——从最基本的几何动画到上美影风剪纸/赛璐珞风格,从机械 macOS 朗读到 XiaoxiaoNeural 情感旁白,从七幕平铺到九幕多镜头运镜。文章包含技术选型对比、踩坑实录、以及每一版的视觉演变对比。
▲ 最终成品:招财金蟾 · 缘起(98秒,九幕多镜头版,XiaoxiaoNeural 旁白)
这个故事的起点,是一段流传在中国民间神话中的叙事——
天地初开,女娲娘娘炼五色石以补苍天。补天既毕,尚余三石,零落人间。
其一迸裂于花果山,化为石猴,号美猴王,保唐僧西行——是为孙悟空。
其一衔玉而生,名唤宝玉,历尽悲欢——是为贾宝玉。
其一坠于淤泥浊水,千年风霜,渐成蟾形,只进不出,镇宅守财——是为招财金蟾。
今人欲拜金蟾,须以黄金为信,先拜而后求——此乃「先拜金蟾」之缘起也。
一段如此精妙的文本,如果用动画演绎出来,会是怎样的体验?更重要的是——如果全程用 AI 工具来完成,从脚本到配音到画面到剪辑,会面临哪些挑战?
带着这个好奇心,我开启了一段从代码到动画的创作实验。
要做"程序化生成动画",目前最成熟的方案是 Remotion——一个基于 React 的视频框架。它的核心思路是:
React Components → 逐帧渲染 → FFmpeg 合成 → MP4
这意味着你可以用熟悉的 JSX 来"画"每一帧,用 spring 和 interpolate 来做动画缓动,用 Sequence 来编排时间轴。它本质上把你从 AE/PR 的时间线拖拽中解放出来,变成写代码——一个前端开发者的动画工作流。
选择 Remotion 还有两个关键原因:
① 声音先行工作流:传统视频制作是先剪辑画面再配音,但对于念白+画面的神话叙事,理想流程应该是——先生成有情感的自然旁白 → 根据旁白时间戳编排场景 → 动画跟随声音节奏。Remotion 可以在代码中精确控制每个 Sequence 的起止帧,天然适配"旁白驱动"。
② 风格可控:动画的"画面"本质上是 SVG + CSS + Canvas 的组合。这意味着你可以定制出任何视觉风格——水墨、剪纸、赛璐珞、浮世绘——而不受模板限制。
v1.0 · 初版 → v2.0 · 声音先行 → v3.0 · 上美影风 → v4.0 · 九幕多镜头
第一版的核心问题是:如何让 Remotion 发出自然的人声?
最初我用了 macOS 自带的 say 命令——一行命令就能合成中文朗读:
say -v Tingting -o audio.aiff "天地初开,洪荒既判。"
结果是……像导航语音。没有情绪,没有起伏,甚至断句都不太对。这一版的画面也很"程序员"——几何圆形当石头,渐变色当背景。7 个场景,48 秒,每幕 6~7 秒的简单动画。完成度很低,但验证了技术可行性。
要自然的旁白,需要神经网络 TTS(文本转语音)。我调研了三个选项:
| 方案 | 费用 | 中文质量 | API难度 |
|---|---|---|---|
| 阿里云 CosyVoice | 套餐内 | ⭐⭐⭐⭐⭐ | 中等 |
| 微软 Edge TTS | 完全免费 | ⭐⭐⭐⭐ | 较高 |
| macOS say | 免费 | ⭐ | 极低 |
在没有付费套餐的情况下,Edge TTS 成了最优选。它是微软 Edge 浏览器内置的"大声朗读"功能的后端,通过 WebSocket 协议暴露,完全免费、无需 Key。中文女声 XiaoxiaoNeural 的嗓音自然度接近真人朗读。
但调用它需要拼一个特殊的认证令牌:Sec-MS-GEC——一个基于时间的 SHA-256 哈希。核心算法:
const t = Math.floor(Date.now()/1000) + 11644473600;
const ticks = (t - t%300) * 10000000n;
const token = SHA256(ticks + "6A5AA1D4EAFF4E9FB37E23D68491D6F4");
搞定 TTS 后,我设计了一个"声音先行"工作流:
script.json(剧本真源)
   ↓ tts.mjs(合成 + 逐字时间戳)
   ↓
audio/*.mp3 + timings.json
   ↓ Video.tsx(驱动时长 + 卡拉OK)
   ↓ remotion render → MP4
这一版的画面是"水墨��金"风格——深色背景、金色文字、几何化的山石与人物剪影。信息量有所提升,但离"美"还差得远。
用户的一句话让我有了方向:"上海美术制片厂的动画风格,剪纸或者赛璐珞。"
上美影的经典动画(《大闹天宫》《哪吒闹海》《天书奇谭》)有一个共同特征:粗墨轮廓 + 平涂色彩 + 手工感。在 SVG/React 中实现这个效果,我用了三个核心技术:
① 剪刀边缘抖动—— 对 Paper 层应用 feTurbulence + feDisplacementMap,让墨线边缘轻微不规则,模拟剪纸的手工切痕。
② 宣纸底 + 民间色—— 暖米色背景(#f1e3bf),叠加 SVG 噪声纹理(mixBlendMode: multiply),暗角加阴影。色彩方案取自民间年画:朱红、金、翠、靛、赭。
③ 纸片"剪入"运动—— 用 spring 模拟剪纸片落在桌面上的弹跳,而非平滑的 ease。随机飘浮的微尘金点增添"纸面"感。
这一版还加入了传统民间纹样:回纹边框、祥云、海水江崖、方孔钱、莲花座、窗花团花、朱文印章。画面信息量大幅提升。
v3 虽然风格化了,但还有一个根本问题:没有镜头。每一幕都是静止画面 + 轻微漂移,像在看一本翻动的画册。
要让画面有电影感,需要镜头语言——推、拉、摇、移、升、旋。我在 v4 中实现了一个完整的 Camera 系统:
const cam = buildCam(frames, [
  [0,    0,   0,  1.0,  0],    // 起:宽广镜
  [0.4,  0, -60,  1.3,  0],    // 推:逼近特写
  [0.75, 60,-20, 1.22,  3],    // 旋:轻微环绕
  [1,    0,   0, 1.12,  0],    // 落:回正
]);
同时把脚本从 7 幕扩充为 9 幕——加入了序章(共工触不周山、天倾地陷)、更详细的补天神话(断鳌足、杀黑龙、积芦灰)、花果山水帘洞瀑布、以及尾声中的三石回顾。新增了 8 个神话母题:不周山裂峰、炼石炉火、黑龙剪影、鳌托四极、水帘洞、朱门红楼、通灵宝玉发光体、元宝堆。
镜头多了,画面就需要有景深。我实现了一个 Far 视差层:远背景跟随镜头平移但幅度缩小(depth=0.45),近景在 Camera 内全量运动。这样在镜头推近时,前景和后景以不同速度移动,形成了基本的空间感。
Edge TTS 虽然是免费的,但它有严格的 IP 限流。在本机直接调用时,WebSocket 握手成功但返回 0 字节音频,甚至返回 403 全量封锁。这意味着在渲染的关键时刻,旁白可能突然"哑了"。
调查了一轮替代方案:Google TTS 在这台机器的网络环境中不可达,有道词典接口已失效返回 500,macOS say 虽然永远可用但声音太机械。
最终的关键突破是找到了一个公开部署的 Cloudflare Worker 代理(tts.wangwangit.com),它将 Edge TTS 封装为 OpenAI 兼容的 HTTP API,通过 Cloudflare 的全球边缘网络转发请求——完美绕过了本机 IP 封锁。响应速度极快(约 0.5 秒),完全免费,无需认证。
curl -X POST "https://tts.wangwangit.com/v1/audio/speech" \
  -d '{"input":"天地有大美","voice":"zh-CN-XiaoxiaoNeural"}' \
  --output audio.mp3
通过这个代理,我为 9 个场景全部生成了 XiaoxiaoNeural 旁白——嗓音自然度和之前的版本一模一样,而且再也没有出现过超时或 403。
Remotion 渲染时需要探测音频时长和声道。但它的内置 ffprobe 是一个极其精简的静态编译版本——只支持 MP3 和 AAC,不支持 AIFF、不支持滤镜(除了 volume)。当用 macOS say 输出 AIFF 时,需要先用 afconvert 转 WAV,再用 afinfo(macOS 原生工具)获取真实时长,才能写入正确的 timings。
上美影风的 SVG 滤镜(feTurbulence + feDisplacementMap)在每一层 Paper 组件上都会触发 GPU 重新计算。9 个场景中,每个场景有 3~6 个 Paper 层——在 MacBook Pro M-series 上,2956 帧的完整渲染耗时约 3 分钟,在可接受范围内。如果需要更高分辨率或实时预览,建议减少滤镜层数或降低 numOctaves。
| 维度 | Edge 直连 | CF Worker 代理 | macOS say |
|---|---|---|---|
| 自然度 | ⭐⭐⭐⭐ 极佳 | ⭐⭐⭐⭐ 极佳 | ⭐ 机械 |
| 逐字时间戳 | ✅ 原生 | ⚠️ 需估算 | ❌ 需估算 |
| 稳定性 | ❌ IP 限流 | ✅ CF 全球网络 | ✅ 永远可用 |
| 费用 | 免费 | 免费 | 免费 |
本文最终版使用的是方案 B——Cloudflare Worker 代理。它既有 XiaoxiaoNeural 的自然嗓音,又通过 Cloudflare 的边缘网络避开了微软的 IP 限流,是目前"免费 + 高质量中文旁白"的最优解。如果你有阿里云 CosyVoice 或火山引擎的 token,还可以获得更精细的情感控制能力。
以下是最终版中九个场景的代表性帧,展示了从序章天倾地陷到尾声聚宝守财的完整��事弧线,以及不同场景中镜头语言的变化。图片文件位于项目 images/ 目录中。
|
标题卡 · 招财金蟾
|
序 · 天倾地陷
|
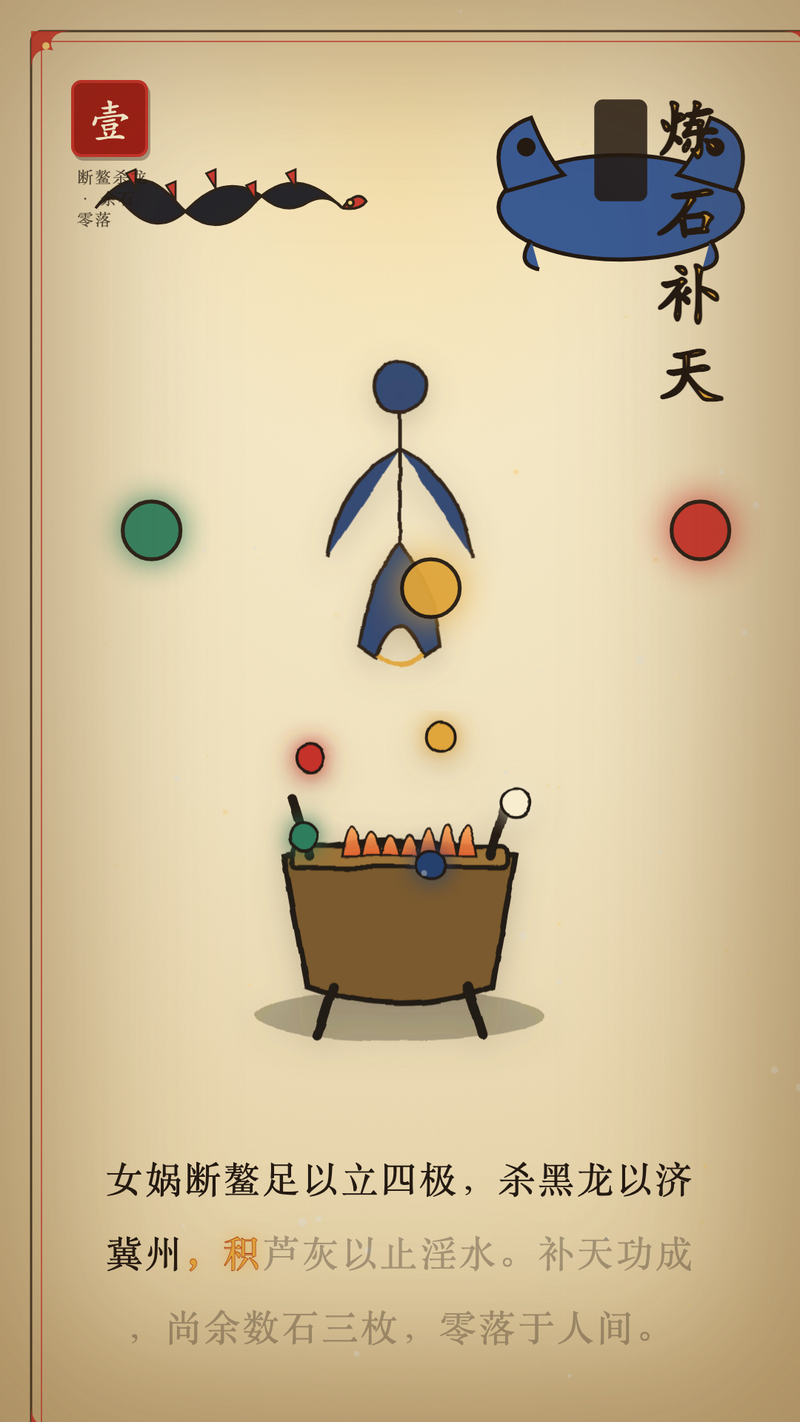 壹 · 炼石补天
|
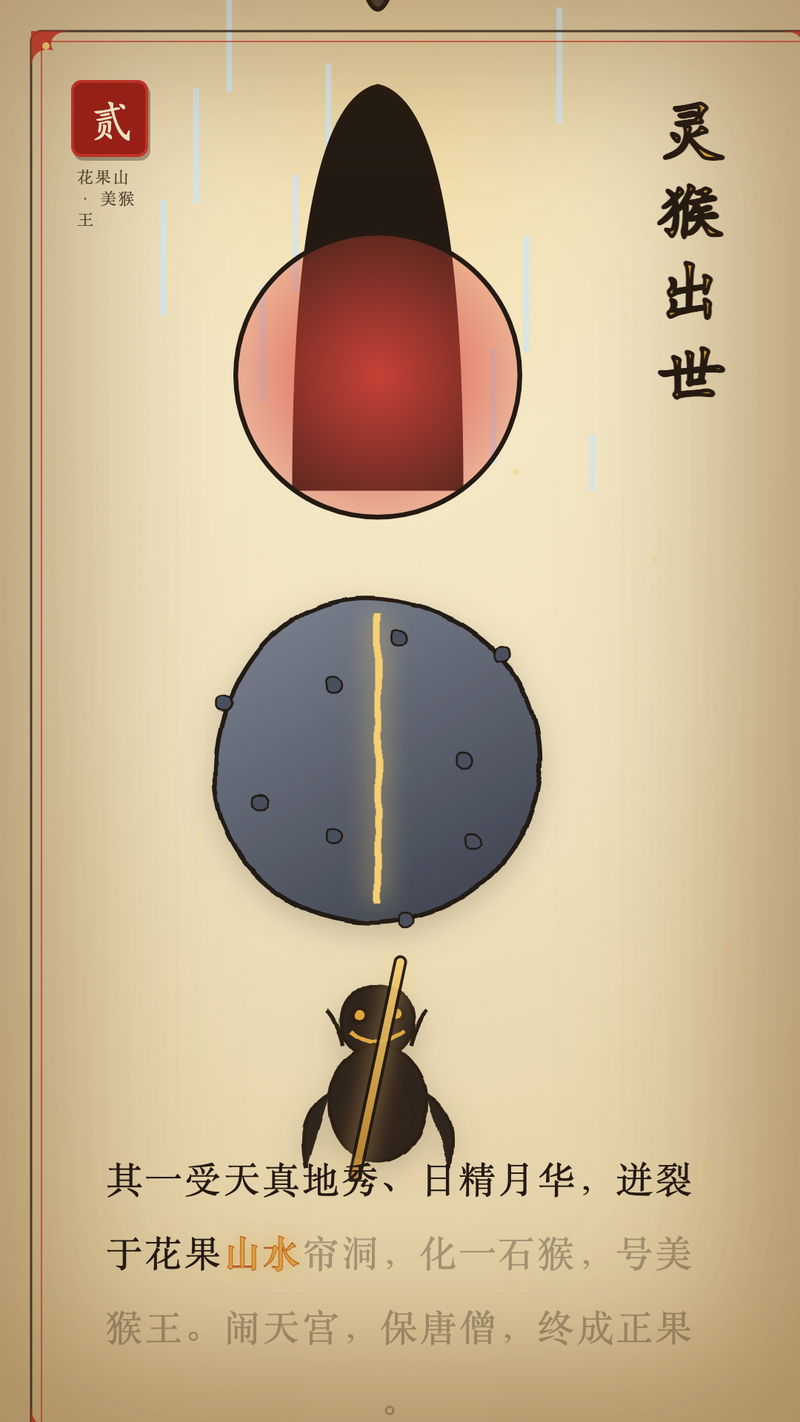 贰 · 灵猴出世
|
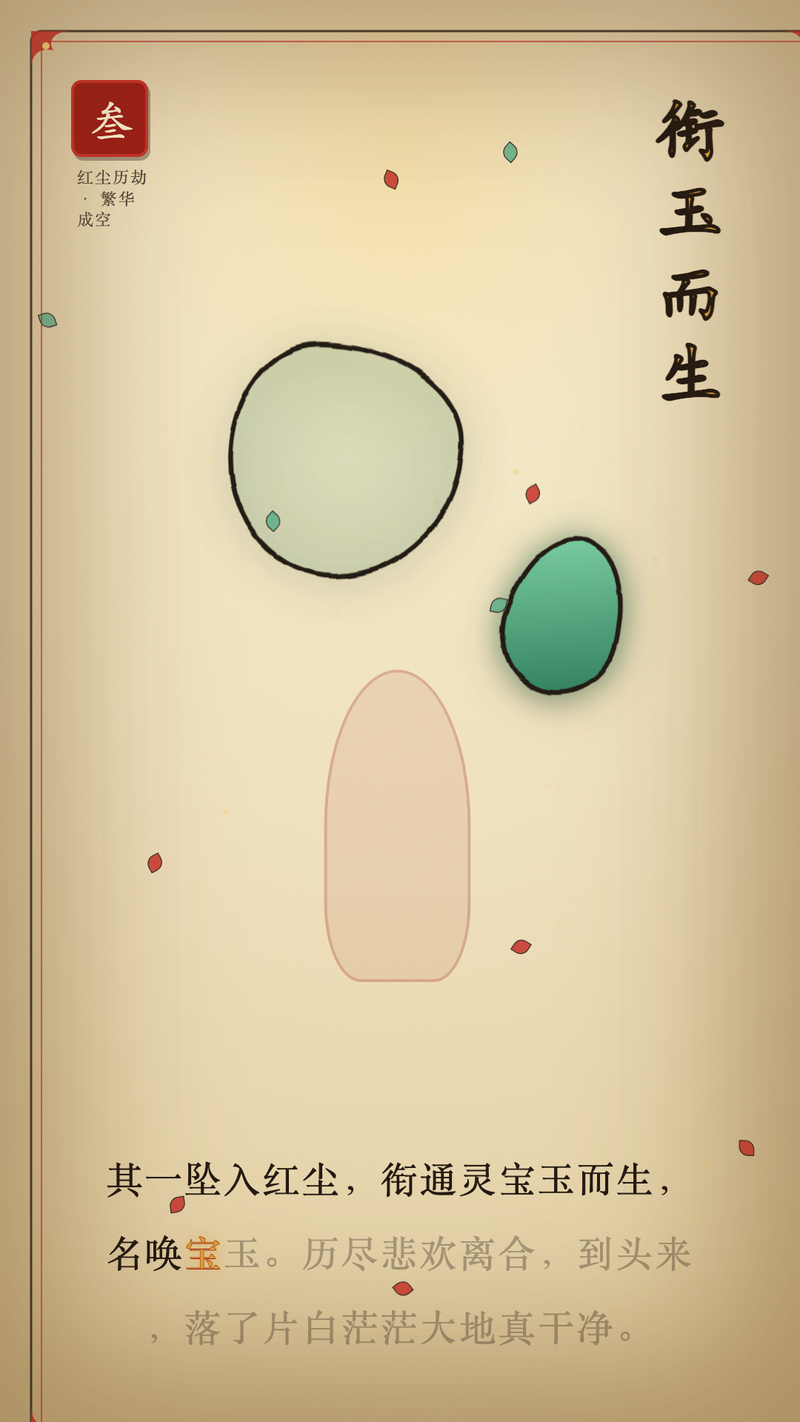 叁 · 衔玉而生
|
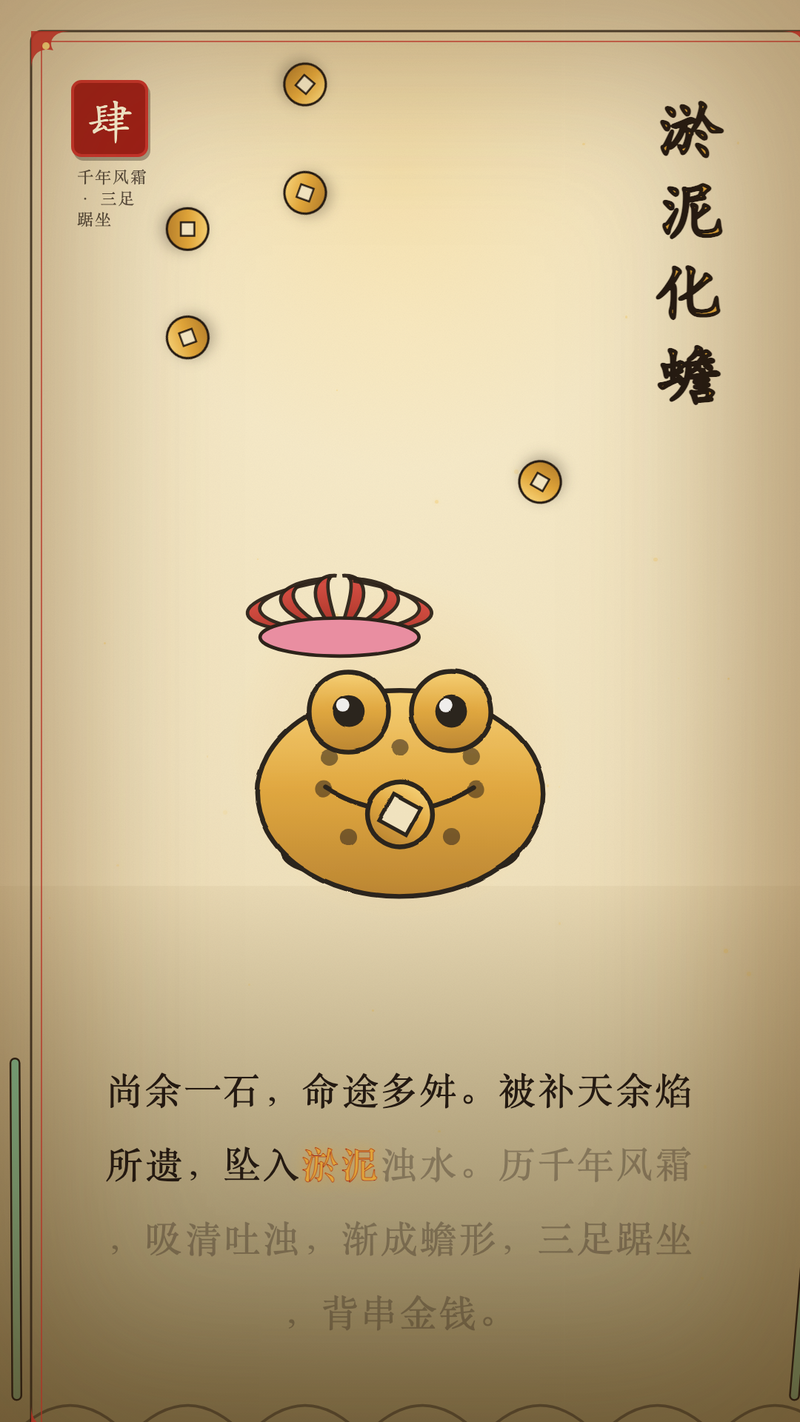 肆 · 淤泥化蟾
|
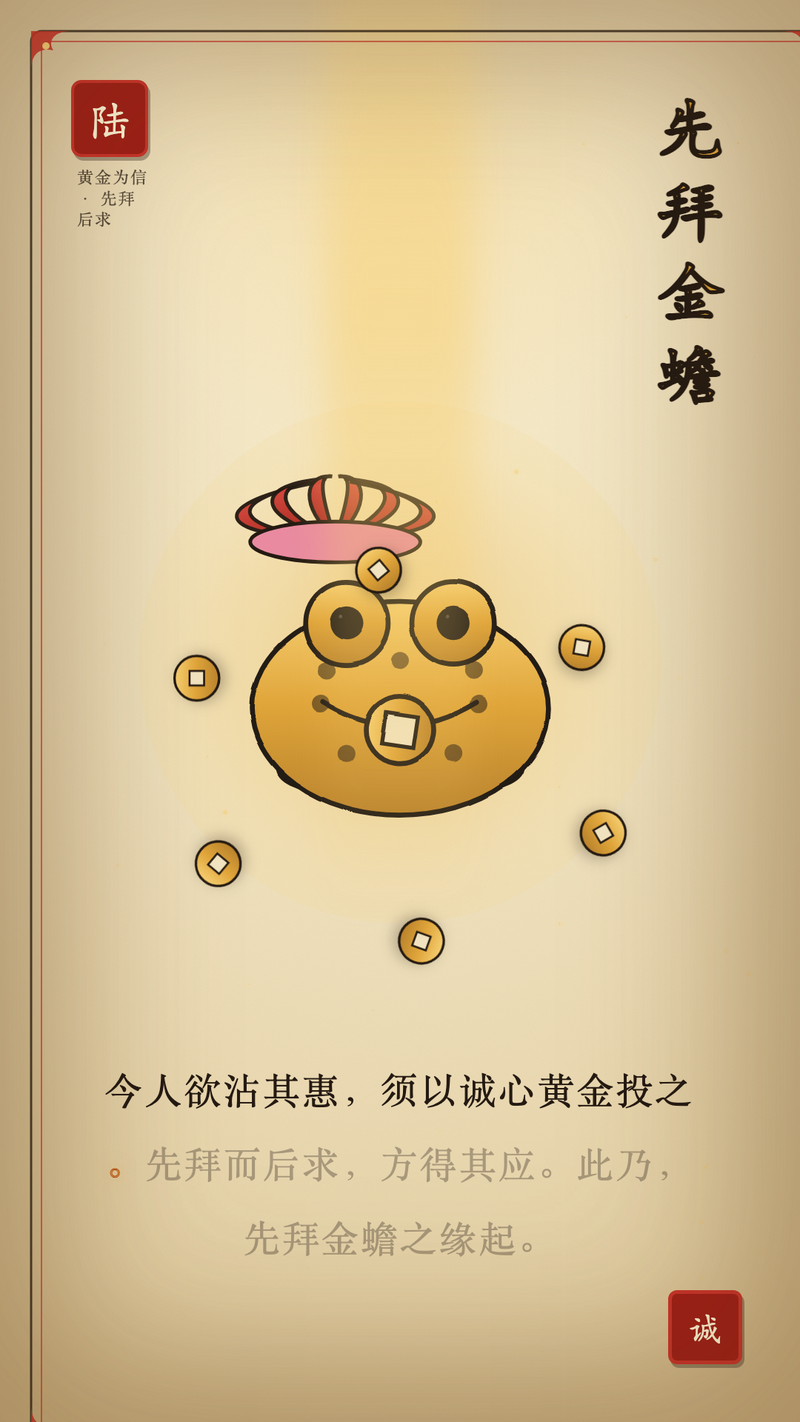 伍 · 招财金蟾
|
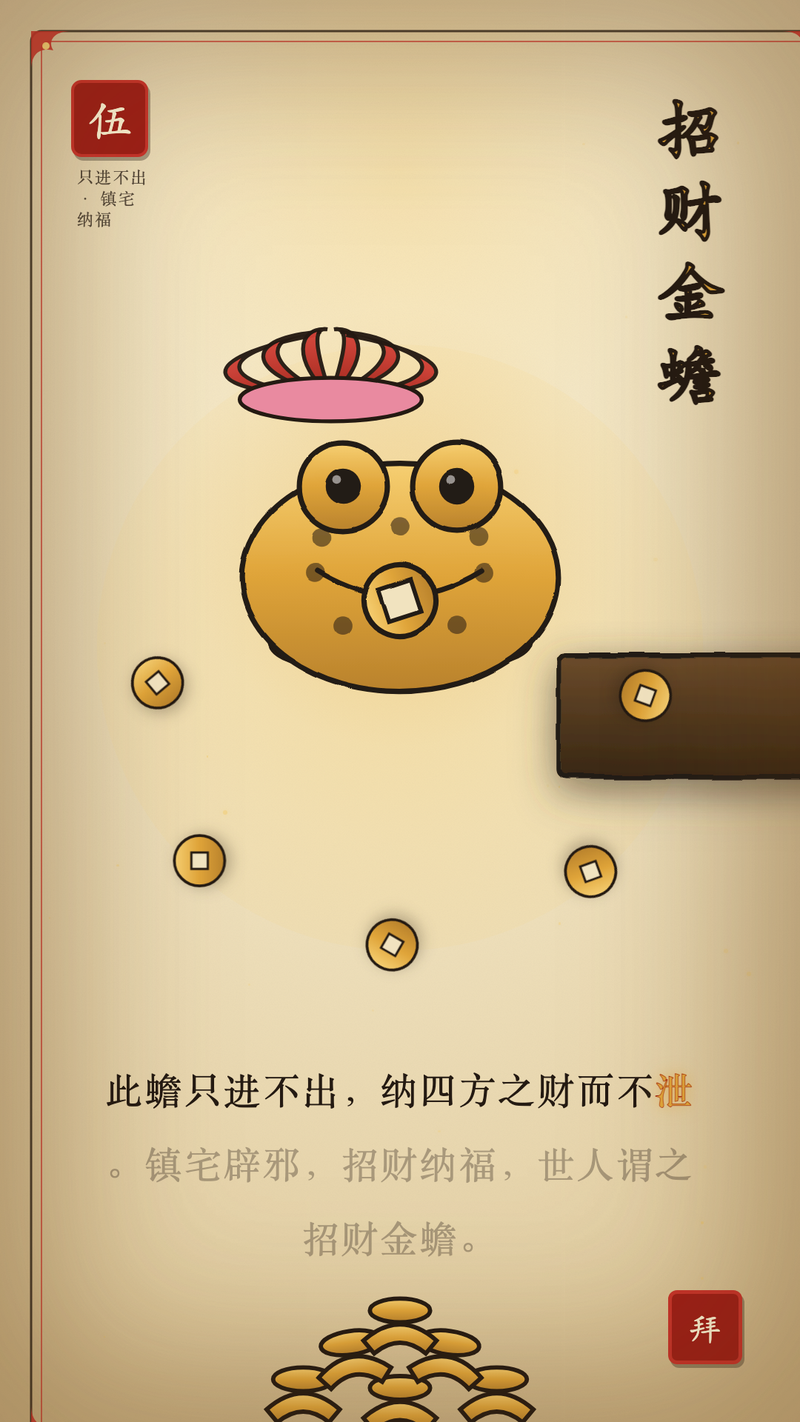 陆 · 先拜金蟾
|
① 门槛降低了,但"美"的门槛没有。Remotion 让一个前端开发者可以在几个小时内搭出完整的动画流水线,生成一个"能看"的视频。但要让画面有风格、有韵味、有电影感,需要的不是更多的代码,而是更多的"审美决策"——用什么颜色?母题从哪来?镜头怎么运动?这些是 AI 目前帮不了你的。
② 程序化视频的核心瓶颈不是渲染速度,而是"信息密度"。一个 7 幕 70 秒的视频和 9 幕 98 秒的视频,渲染时间差异不大(2 分钟 vs 3 分钟)。真正的差异在于——后者每幕有 2~3 个镜头运动、5~8 个子元素、多层视觉纹样。信息密度翻倍,但实现复杂度翻了数倍。
③ TTS 是声音驱动视频的关键,也是最大的不稳定因素。免费的神经网络 TTS(Edge)质量足够好,但不稳定。找到 Cloudflare Worker 代理这个"绕道方案",才真正解决了稳定访问的问题。如果做生产级的自动化视频内容,建议用付费方案(CosyVoice/火山引擎)替换。
④ "声音先行"是叙事类视频的最佳工作流。先生成旁白,根据旁白时间戳来编排动画——这个流程让画面节奏天然跟随语音节奏,避免了"配音"与"画面"打架的尴尬。
从"用代码画动画"的猎奇尝试,到"九幕神话多镜头运镜"的 98 秒完整短片——这次创作让我深刻体会到:AI 工具正在把"创作"的下限不断抬高,但上限依然取决于人的审美、判断和想象力。
代码能生成画面,但决定画面美不美的,是你选择的那组颜色、那条母题、那组镜头运动——这些选择,暂时还无法交给 AI。
感谢阅读 🙏
本文全部视频由 Remotion (React) + Edge TTS (via Cloudflare Worker) 生成。所有视觉元素为手写 SVG + React 组件,未使用任何视频素材库。
© 2026 · 招财金蟾 · 缘起